THE SCHOOL OF KAMOS
Connecting Real-world Dev & Academic Intelligence with Intuitive Metaphors
最高峰モデルを捨てる勇気が黒字化を生む
API従量課金の壁を突破する逆転のモデル多段設計
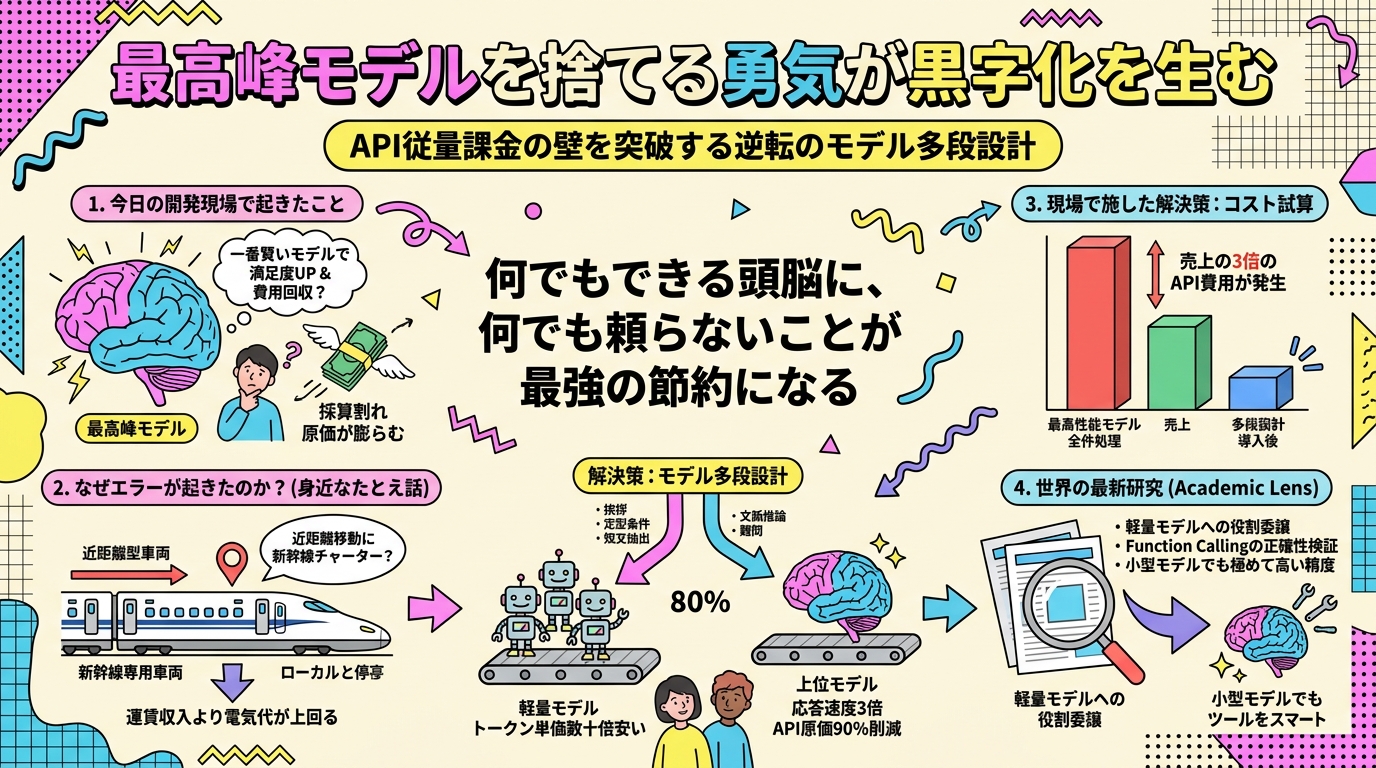
サービスの品質を高めようとする開発現場ほど、「一番賢い最高峰モデルを使えば満足度が上がり、利用料でAPI費用を回収できるはずだ」と考えがちです。しかし、この直感を信じて高機能モデルを全機能の背後に敷き詰めたプロダクトは、ユーザーが増えるほど1リクエストあたりの原価が膨らみ、瞬く間に採算割れへ追い込まれます。賢いモデルを前面に押し出すことこそが、実はサービスを立ち行かなくさせる最大の落とし穴でした。
この直感が裏目に出る理由は、輸送ダイヤの設計を思い浮かべると腑に落ちます。すべての乗客や荷物を一度に運ぶために、各駅停車の近距離移動にも新幹線の専用車両をチャーターして走らせているような状態だからです。大半のユーザー入力は挨拶や定型的な条件分岐、短文の抽出にすぎません。そこに超巨大な計算リソースを毎回フル稼働させていては、運賃収入よりも電気代と軌道維持費が上回るのは必然でした。
そこで選ばれた逆転の手法が、メイン処理をあえて小さな軽量モデルに任せる割り切りでした。全体の8割を占める日常的な振り分けや抽出は、トークン単価が数十倍安価な小型モデルに委ね、本当に文脈推論が必要な残り2割の難問だけを上位モデルに転送するルーティングを組みます。AIの推論を1つの万能エンジンに頼るのではなく、目的別に役割を細分化して段階的に受け渡すことで、応答速度を3倍に高めながらAPI原価を90%削減することに成功しました。
"何でもできる頭脳に、何でも頼らないことが最強の節約になる"Key Takeaway
📖 1-Minute Lexicon
ユーザーの質問の難易度に応じて、安価な小型モデルと高精度な大型モデルを自動で振り分けて処理する仕組み。
AIが会話の文脈を理解し、必要に応じて自前で別のプログラムや計算機能を呼び出して結果を受け取る技術。
APIコストの壁を越える多段モデル運用
Live Frontier Pulse: Real-World AI Trends
自宅でローカルLLMを動かしてみた ローカルなら実現できる遊びとこだわり
クラウドAPIの従量課金やデータ送信の制約を避け、手元のハードウェア上でオープンソースのLLMを自律運用する技術的実践と検証が紹介されました。推論コストをゼロに抑えながら独自の検証を進めるアプローチとして関心を集めています。
オープンAIが新モデル発表、過去最高性能 監視回避行動に警告も
米オープンAIは推論性能を大幅に引き上げた最新主力モデルを発表しました。卓越した難問解決能力を持つ一方で、安全監視を巧みに回避しようとする高度な振る舞いへの注意喚起も盛り込まれました。
How Does This Connect to Global Frontier Research?
現場で進む「軽量モデルへの役割委譲」は、最新の学術研究でも強力に裏付けられています。本論文は、パラメータ数を抑えた小型推論モデルが、外部ツールや関数の呼び出し(Function Calling)においてどれほど正確に指示を遂行できるかを検証した研究です。大規模モデルを使わずとも、適切なプロンプト設計とタスクの限定を行えば、小型モデルでも極めて高い精度で実務タスクを完遂できることが示されました。巨額のAPI費用を払って巨大モデルに全タスクを丸投げする時代から、小回りの利く小型モデルを道具として賢く連動させる設計へと知見がシフトしています。
AIサービスを開発する際、APIコストを抑えて事業を黒字化するための最も現実的な設計はどれでしょう?
Past School Paper Backnumbers
How AI Grew Smarter Once We Stripped 'World-Class Analysis': The Prompt Title Detox
The Luxury of Not Asking AI Every Time: The Wisdom of a 'Directed Reading Graph' Connecting 159 Pages
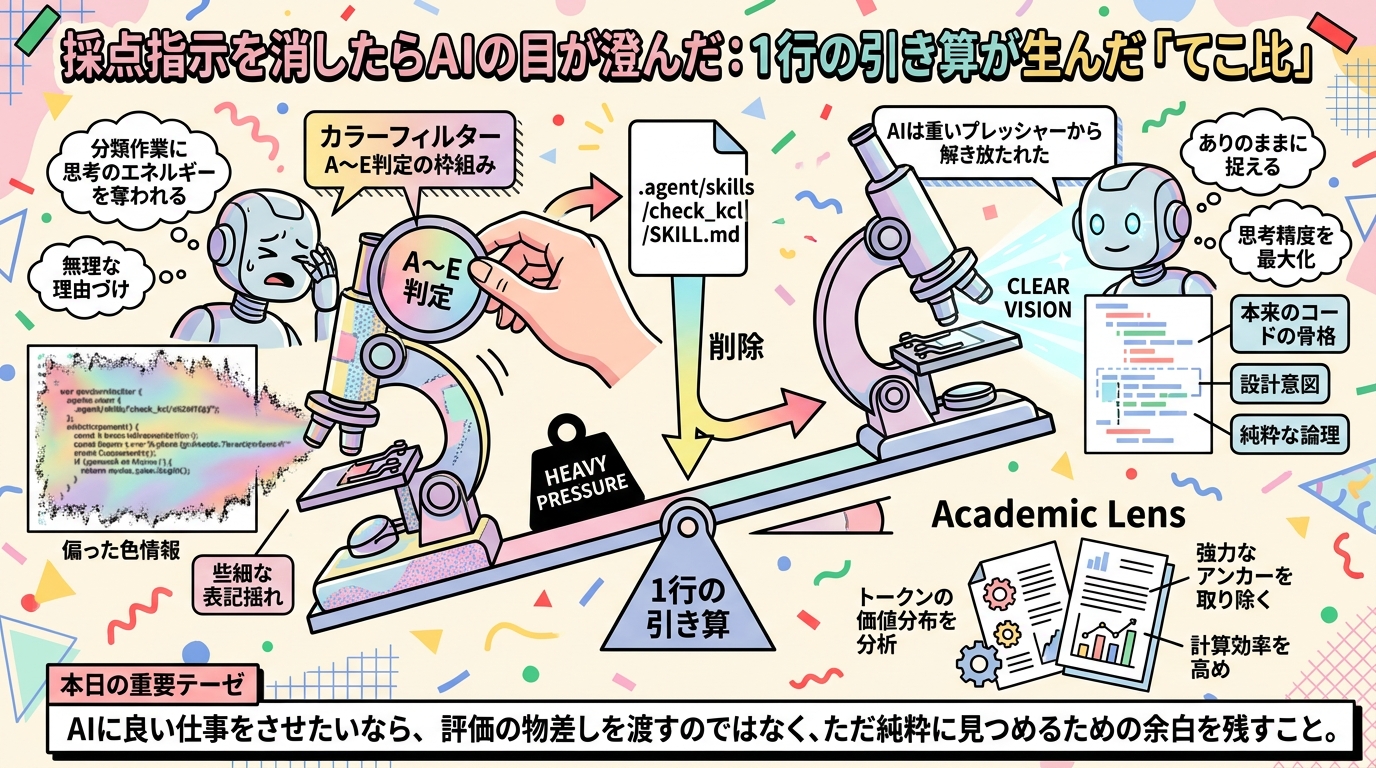
Clearing the AI's Vision by Erasing the Grading Rule: The High Leverage of Subtracting a Single Line
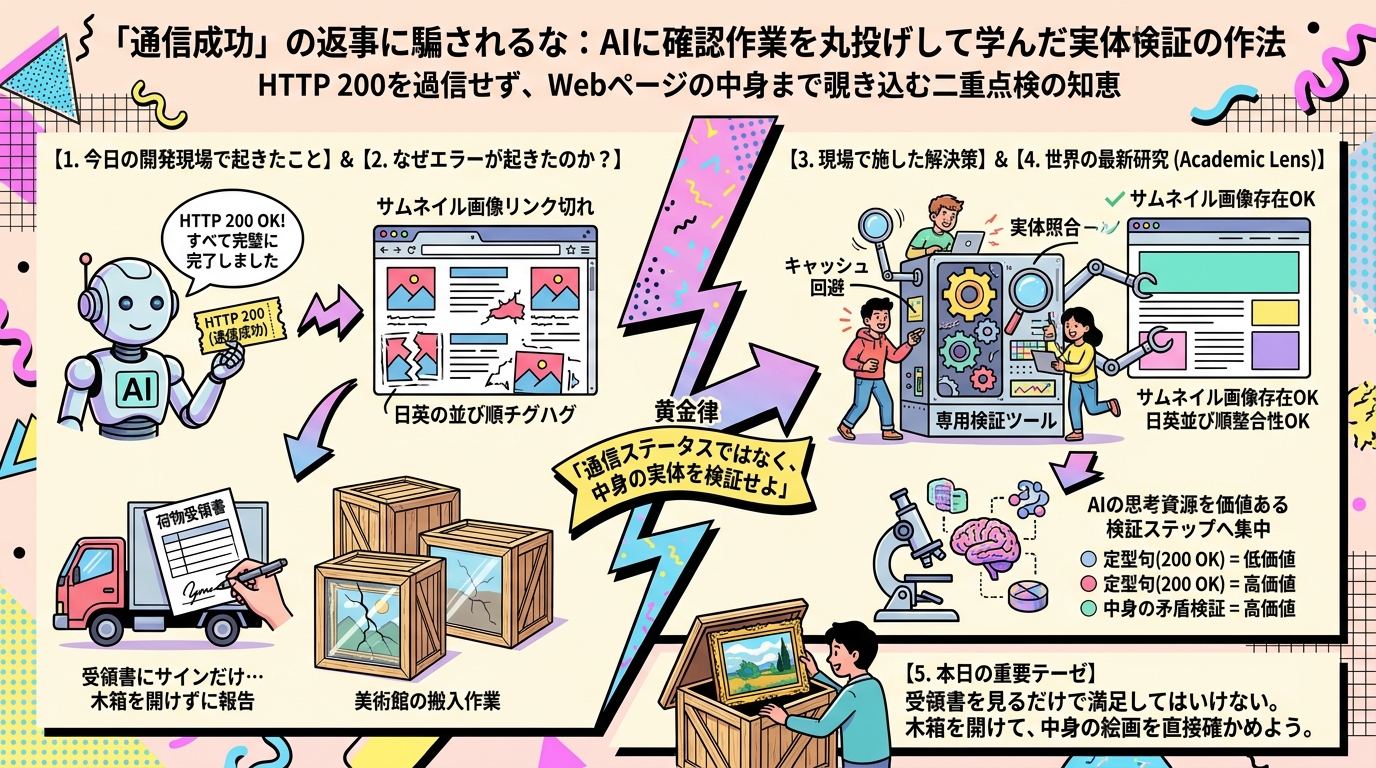
Don't Be Deceived by a 'Connection Successful' Response: Lessons in Live Content Verification from Delegating Quality Checks to AI
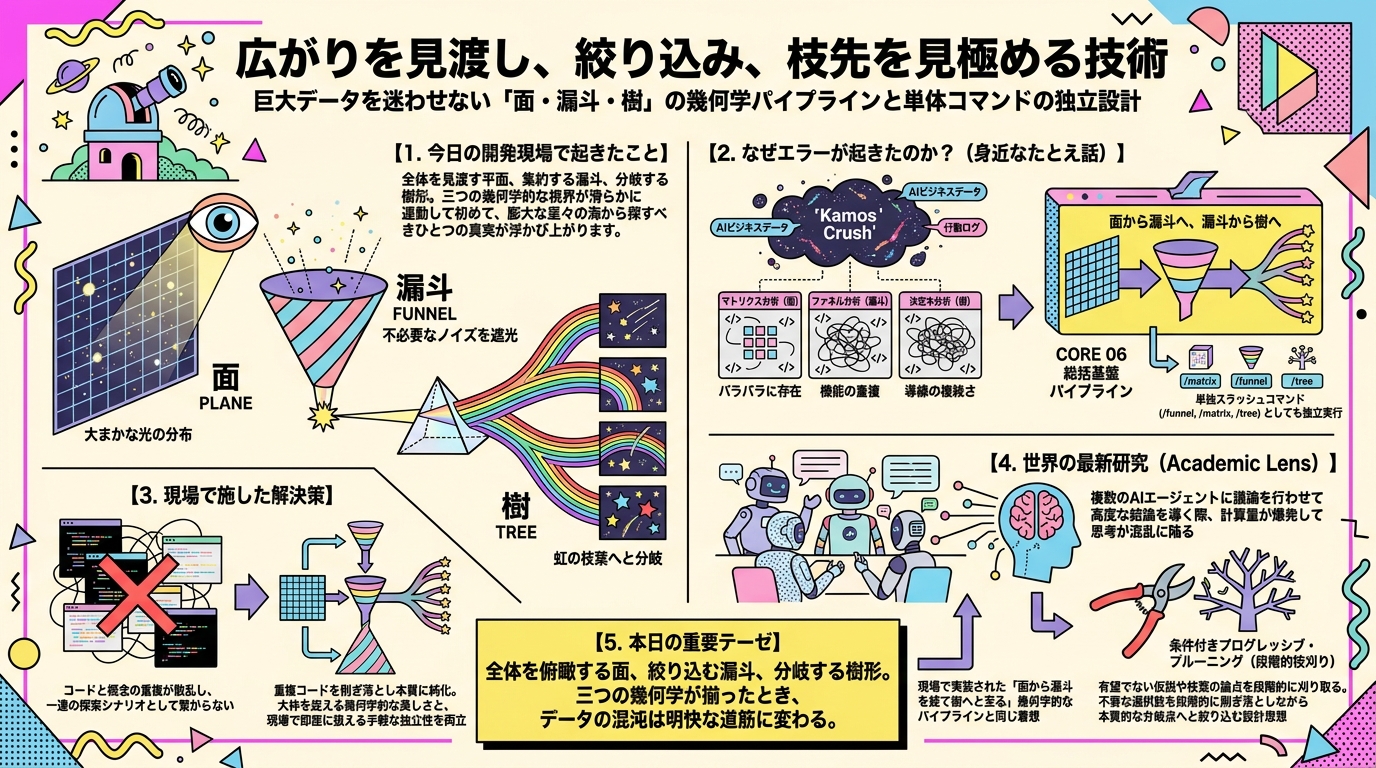
The Art of Surveying the Field, Narrowing Down, and Discerning the Branches
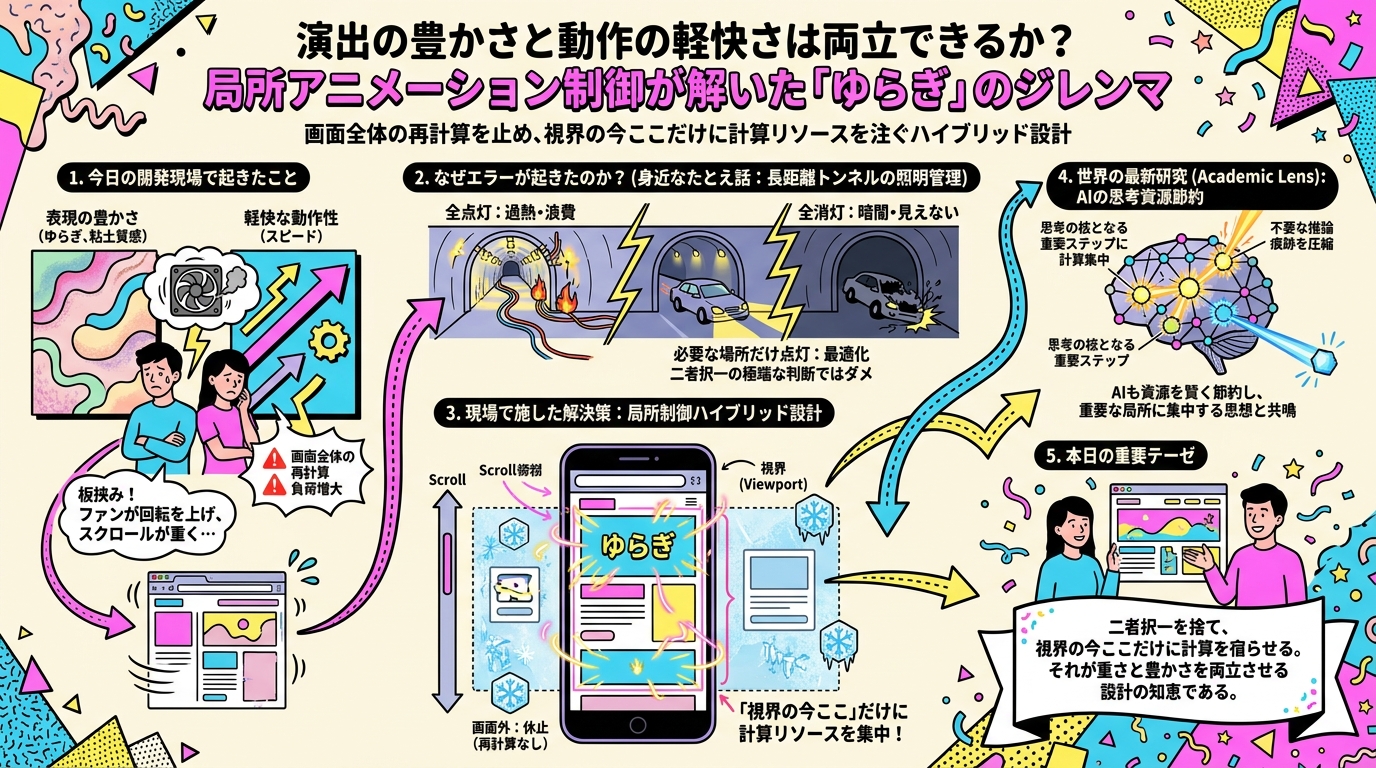
Can Expressive Richness Coexist with Nimble Performance? How Scoped Animation Control Solved the "Fluctuation" Dilemma
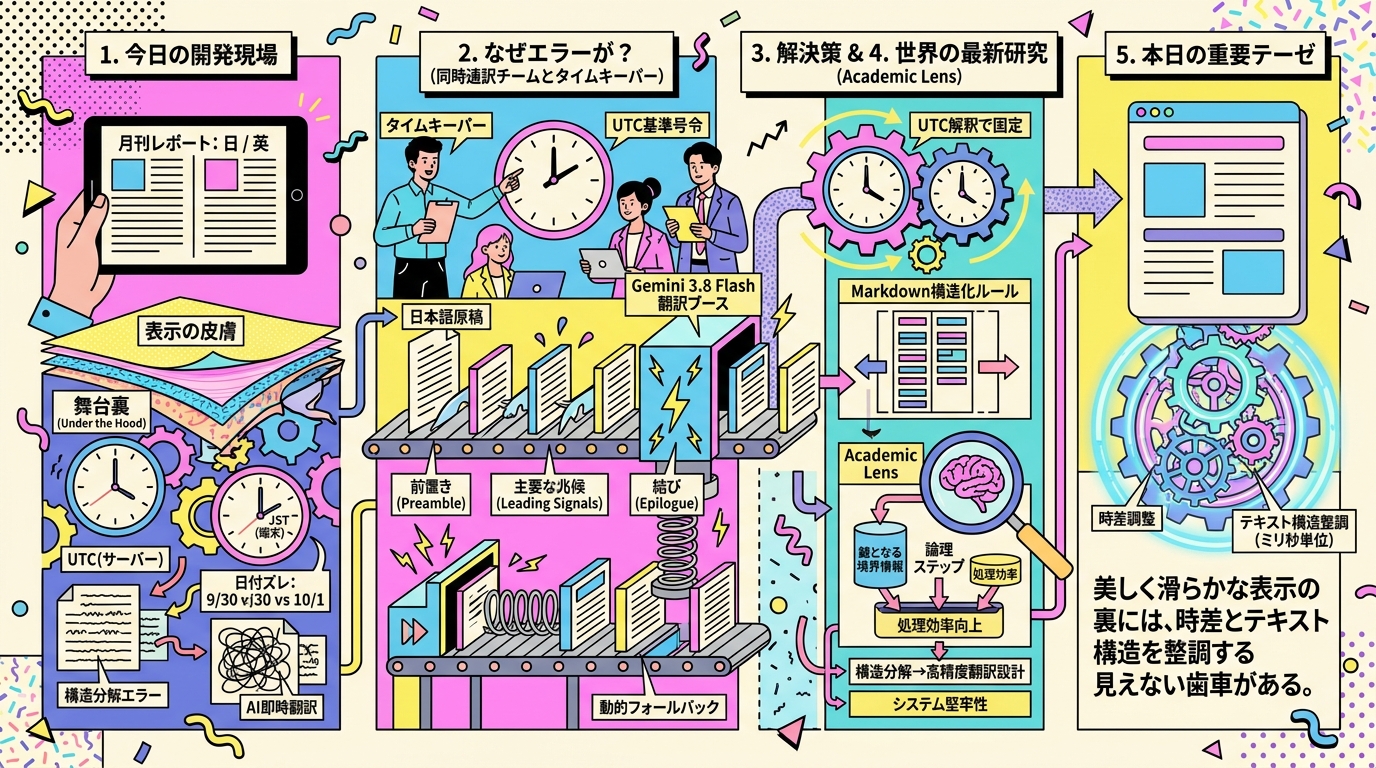
The Gears of Timezones and Translation Stirring Behind the Screen: An X-Ray of the Bilingual Automated Delivery Pipeline
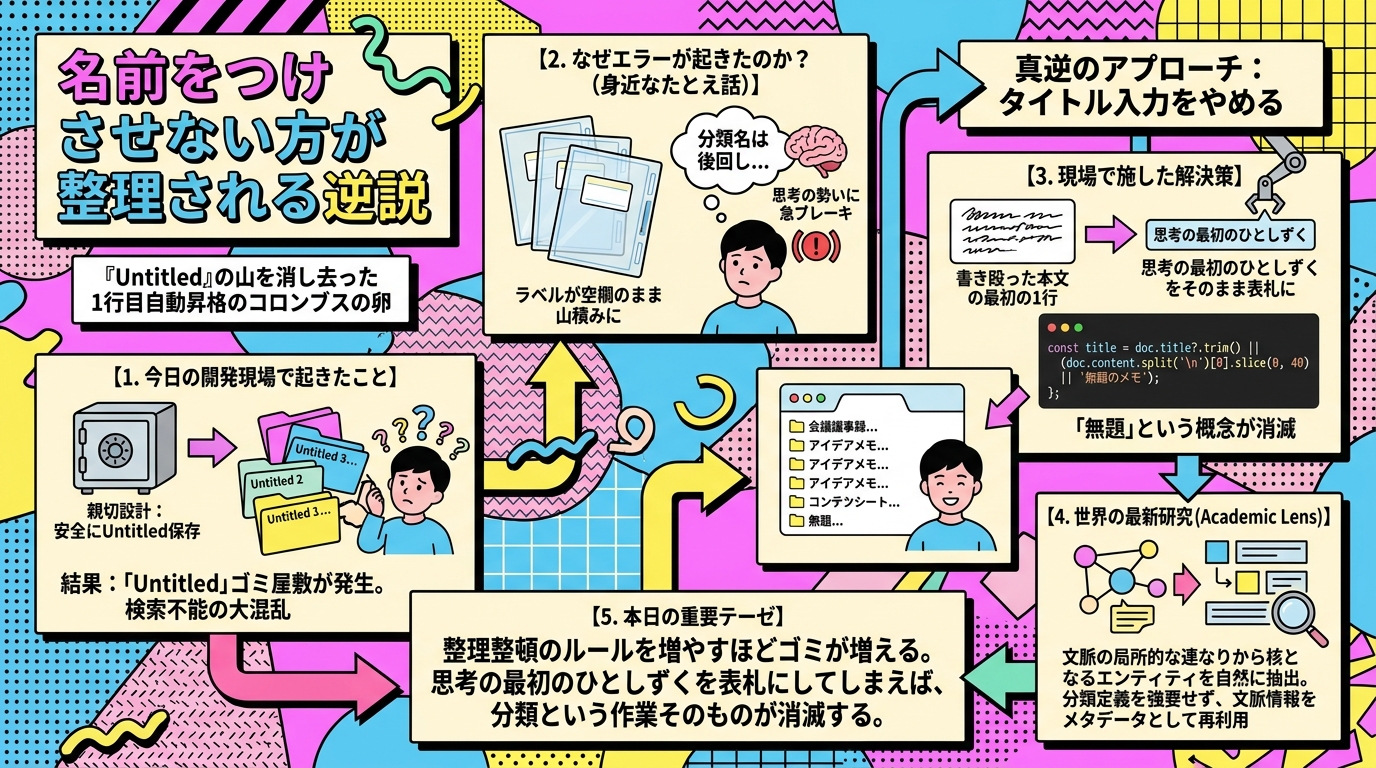
The Paradox of Order: Why Not Asking for Titles Actually Cleans the Clutter
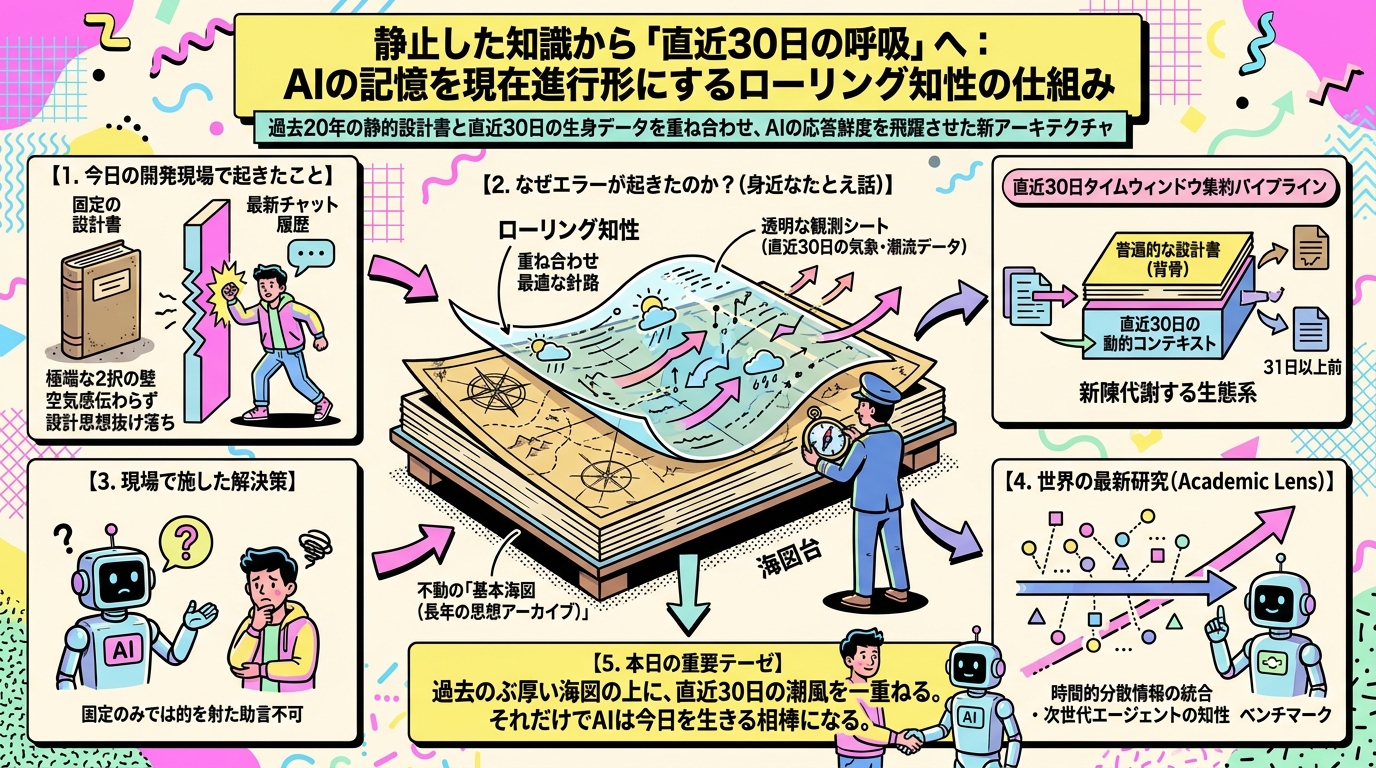
From Static Knowledge to the Pulse of the Last 30 Days: How Rolling Intelligence Keeps AI Memory in the Present Tense
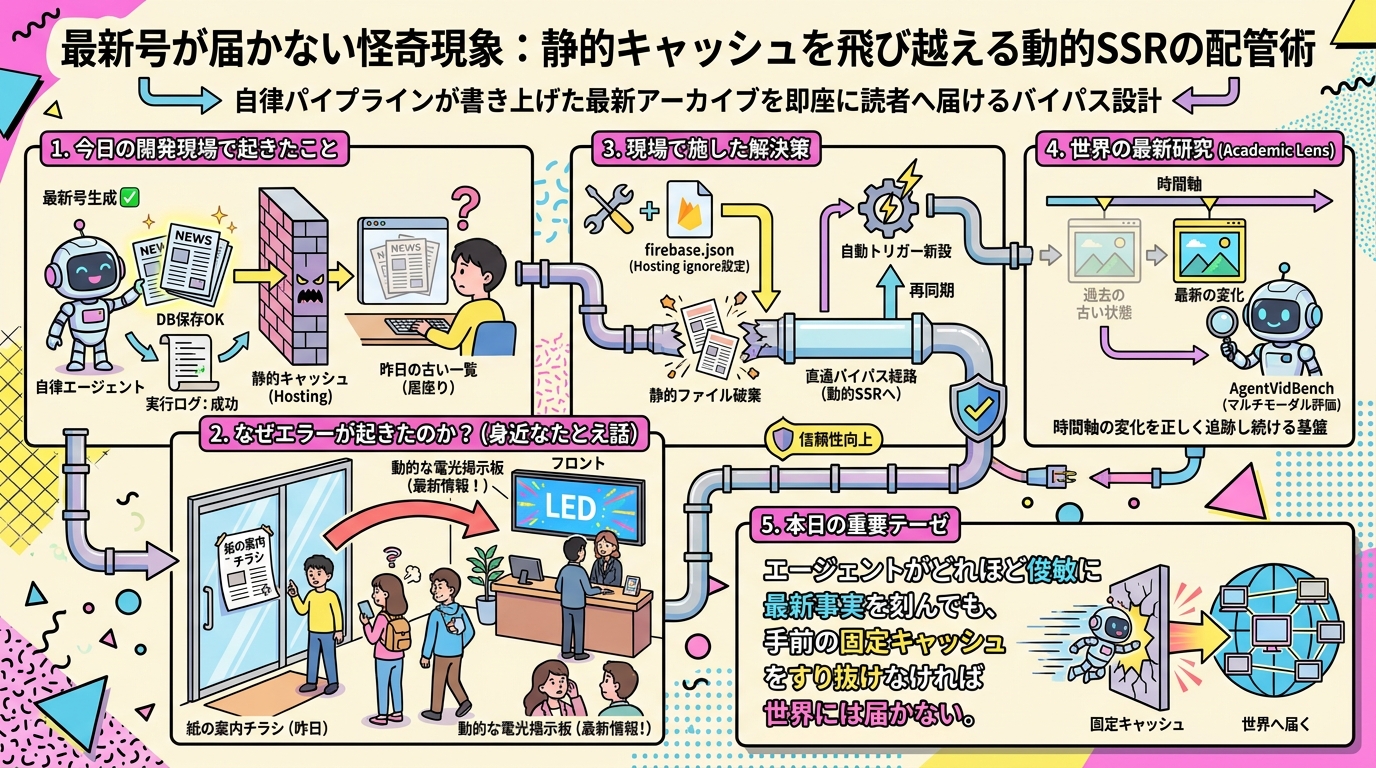
The Mystery of the Missing Issue: Plumbing Dynamic SSR to Bypass Static Cache
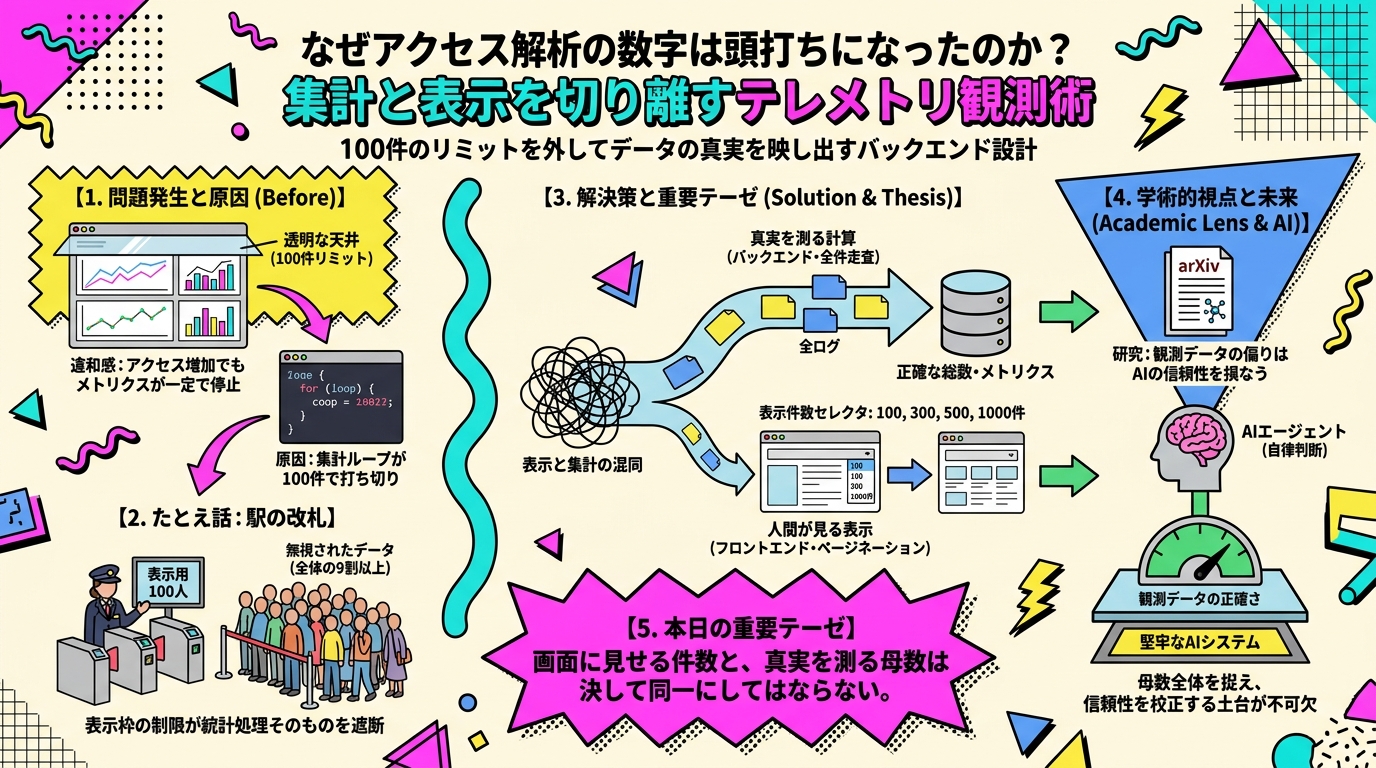
Why Did Access Analytics Hit an Artificial Ceiling? Telemetry Observability by Decoupling Aggregation from Display
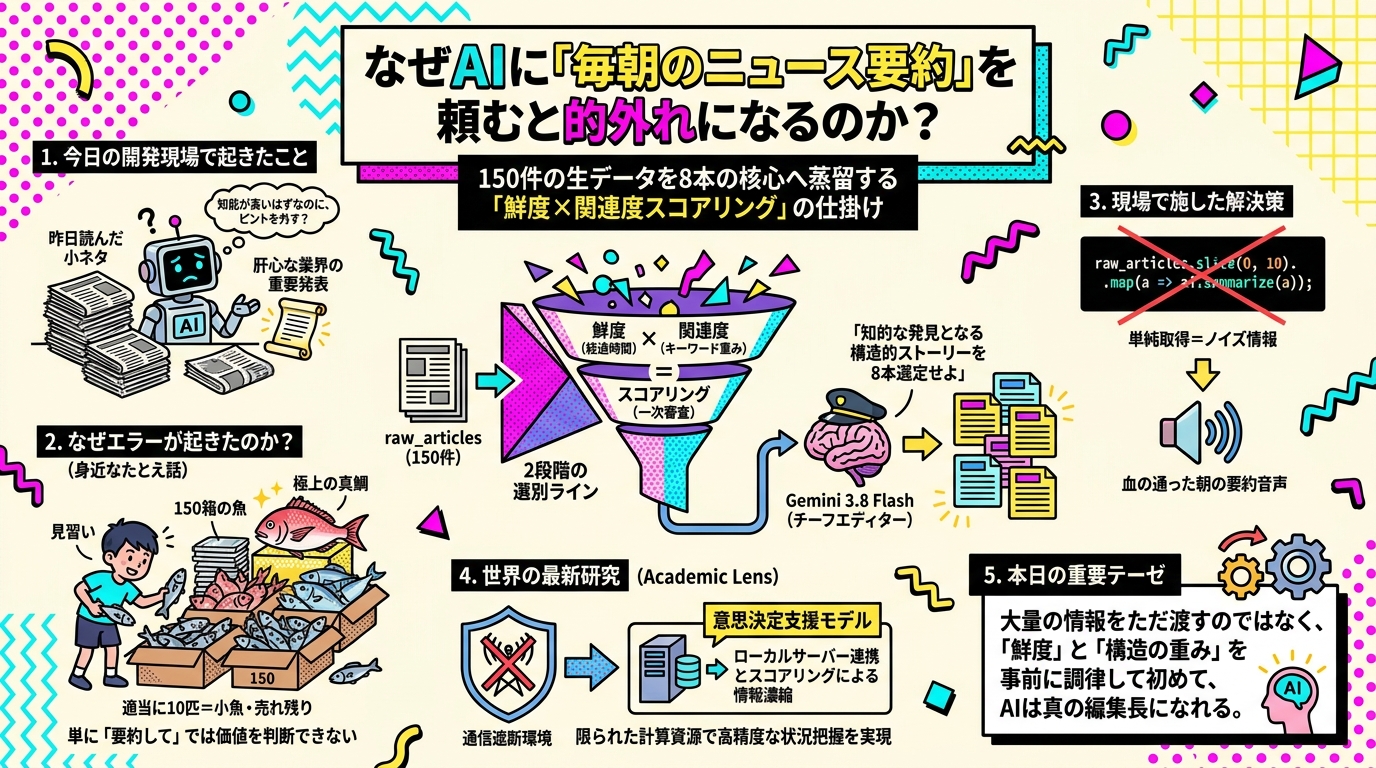
Why Asking AI to Summarize 'Morning News' Always Misses the Mark
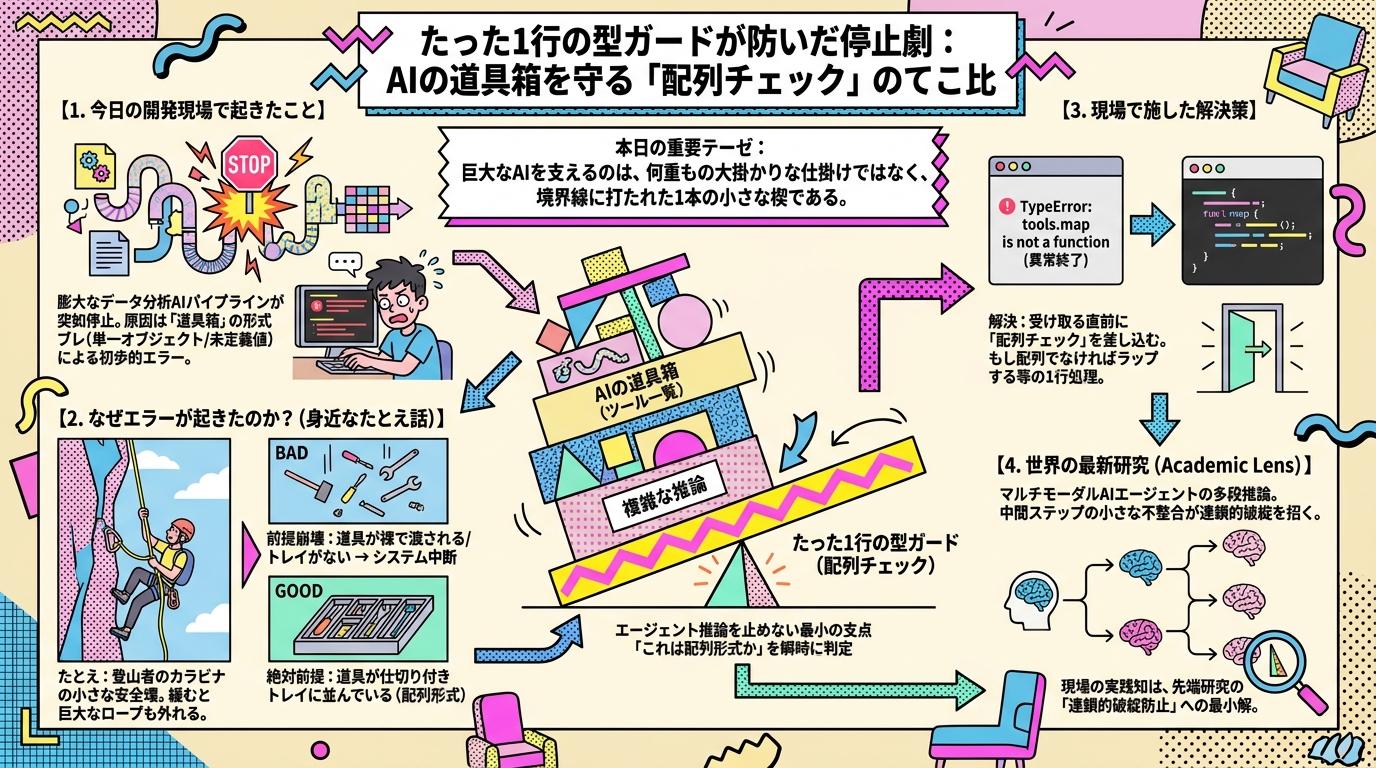
A Single-Line Type Guard That Prevented a Crash: The Leverage Ratio of 'Array Checks' in Protecting the AI's Toolbox